Segunda-feira, 8h. O servidor do ERP não responde. O backup da noite rodou, está guardado e íntegro. Mesmo assim, ninguém fatura, ninguém emite nota e o atendimento trabalha no papel. Porque ter a cópia dos dados é uma coisa. Ter onde ligar essa cópia, na ordem certa e com o time conectado, é outra.
É essa distância que a recuperação de desastres em nuvem resolve. Neste artigo explicamos o que ela é, como funciona passo a passo (failover, runbook, failback e teste), quanto custa ficar parado sem ela e o que avaliar antes de contratar.
Resumo rápido
- Recuperação de desastres em nuvem mantém uma réplica dos servidores críticos pronta para ligar fora da empresa. Quando o servidor original cai, a réplica assume.
- Backup devolve os arquivos. Recuperação de desastres devolve a operação: servidores no ar, sistemas respondendo e o time trabalhando.
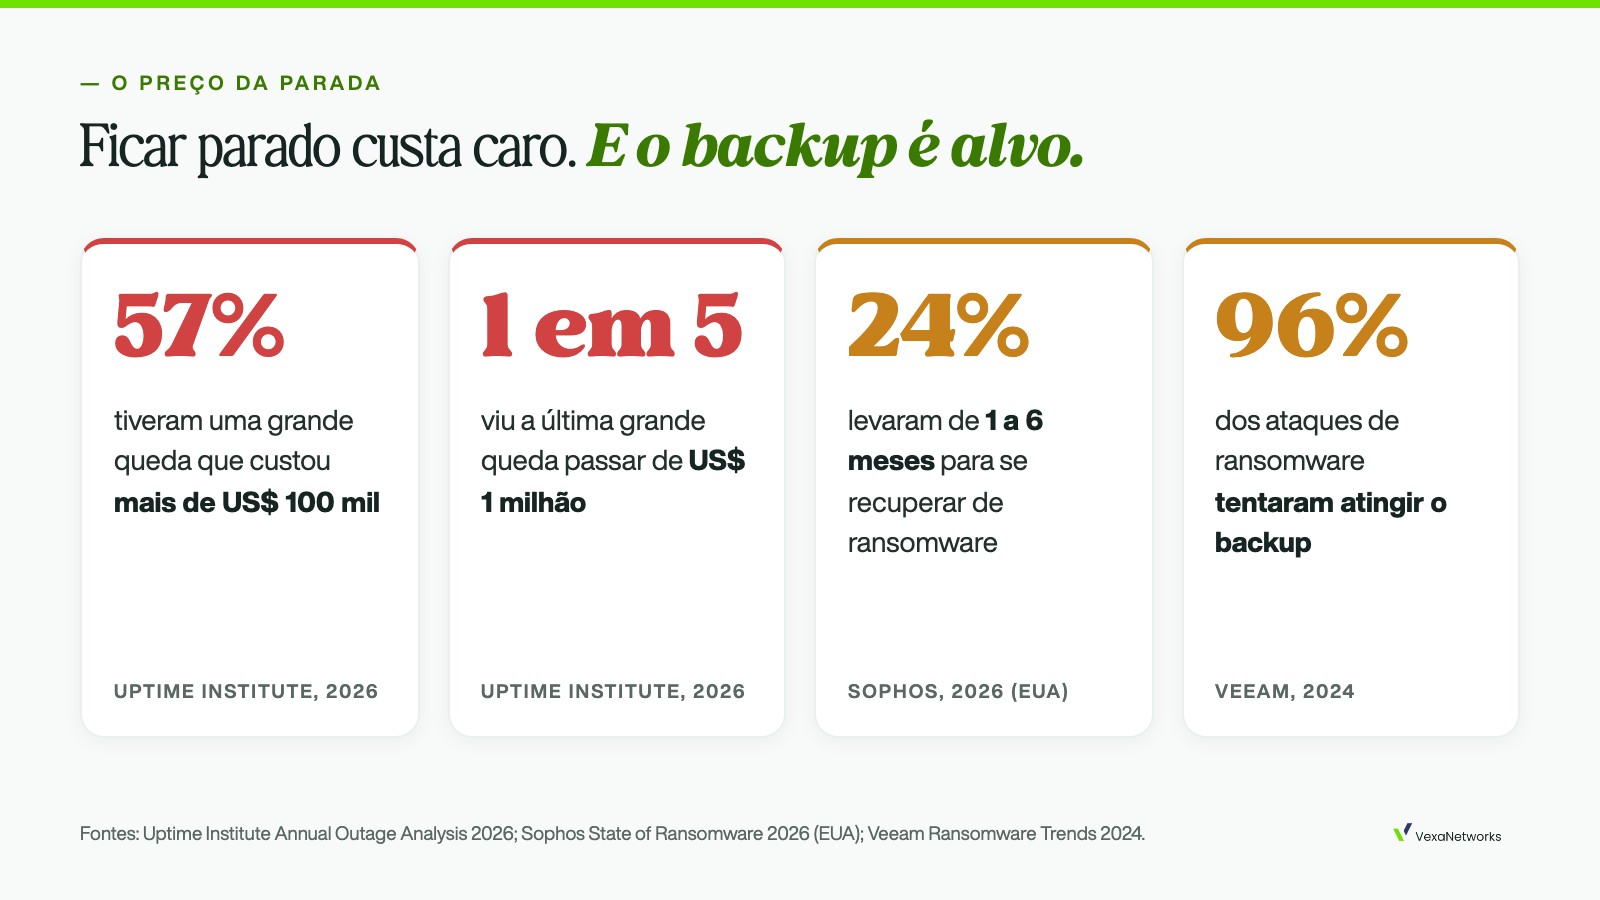
- Ficar parado custa caro: 57% das organizações disseram que a última grande queda custou mais de US$ 100 mil, segundo o Uptime Institute.
- O ciclo tem quatro movimentos: réplica, failover, failback e teste. Os runbooks garantem que tudo volte na ordem certa.
- Um plano que nunca foi testado é uma aposta. O failover de teste em rede isolada permite validar sem parar a produção.
O que é recuperação de desastres em nuvem
Recuperação de desastres em nuvem (disaster recovery em nuvem, ou DRaaS) é manter cópias prontas dos servidores da empresa em um data center na nuvem, para que elas assumam o trabalho quando os servidores originais param. A parada pode ser um ransomware, uma falha de hardware, um incêndio, uma enchente ou um erro humano. A causa muda; a pergunta é sempre a mesma: em quanto tempo a empresa volta a operar?
Sem um plano, a resposta é “quando conseguirmos reconstruir tudo”. Com recuperação de desastres em nuvem, a resposta passa a ser “quando ligarmos a réplica”, e isso costuma ser uma questão de minutos.
Backup e recuperação de desastres não são a mesma coisa
A confusão é comum e cara. O backup é a matéria-prima; a recuperação de desastres é o caminho para transformar essa matéria-prima em operação funcionando.
| Só backup | Backup + recuperação de desastres em nuvem | |
|---|---|---|
| O que garante | Que os dados existem | Que a operação volta |
| Onde o sistema roda depois do desastre | Em um servidor que ainda precisa ser comprado, instalado e configurado | Em uma réplica já pronta na nuvem |
| Tempo típico de volta | Dias | Minutos a horas, conforme o plano |
| Ordem de recuperação | Decidida na hora, sob pressão | Definida antes, em runbook |
| Teste | Raro, porque exige parar algo | Em rede isolada, sem tocar na produção |
Se você quer começar pelo diagnóstico do seu plano atual, o artigo Se o servidor caísse agora, quanto tempo sua empresa ficaria parada? traz um checklist de cinco perguntas.
Quanto custa ficar parado
Indisponibilidade não é só um problema de TI. É venda que não acontece, equipe parada recebendo salário, multa contratual e cliente que vai para o concorrente. Os números mais recentes mostram o tamanho disso:
- No relatório de 2026 do Uptime Institute, 57% das organizações disseram que a última grande queda custou mais de US$ 100 mil, e 1 em cada 5 passou de US$ 1 milhão.
- Para mais de 90% das empresas médias e grandes, uma única hora parada custa mais de US$ 300 mil, segundo a pesquisa de custo de indisponibilidade do ITIC (2024).
- Quando a causa é ransomware, a volta pode demorar muito: no relatório State of Ransomware 2026 da Sophos (EUA), 24% das empresas atingidas levaram de 1 a 6 meses para se recuperar.
- E o backup não fica de fora do ataque: segundo o relatório Ransomware Trends 2024 da Veeam, 96% dos ataques de ransomware tentaram atingir os repositórios de backup.
Como funciona, passo a passo
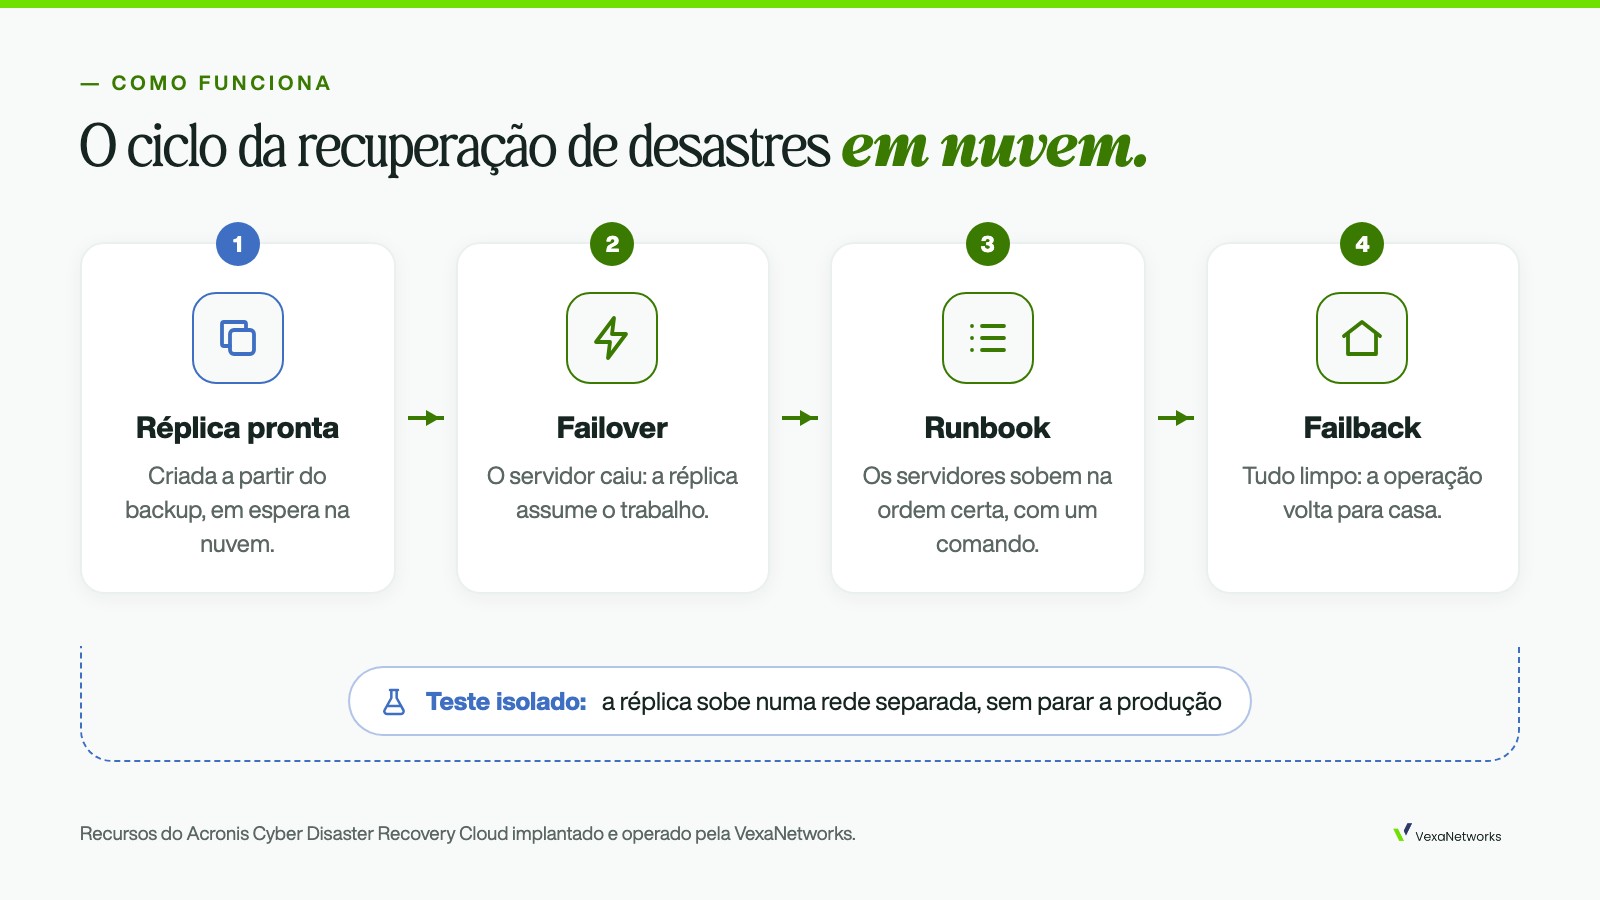
A recuperação de desastres em nuvem funciona em um ciclo de quatro movimentos, mais o teste que mantém tudo confiável. Os exemplos abaixo usam o Acronis Disaster Recovery, a solução que a VexaNetworks implanta e opera.
1. A réplica fica pronta na nuvem
Cada servidor crítico ganha um servidor de recuperação no data center em nuvem, criado a partir dos backups. Ele fica em espera, sem rodar a produção, e é atualizado a cada novo backup. Por isso a frequência do backup define quanto dado você pode perder no pior caso.
2. Failover: a réplica assume
Quando o servidor original cai, o failover liga a réplica na nuvem e transfere para ela o trabalho que o servidor fazia. A rede da empresa é estendida para a nuvem por uma VPN segura, então os usuários e os sistemas continuam encontrando o servidor nos mesmos endereços. Para quem está trabalhando, a diferença é pequena.
3. Runbook: tudo volta na ordem certa
Raramente um sistema depende de um servidor só. O ERP precisa do banco de dados, que precisa do controlador de domínio. Um runbook é a receita que sobe vários servidores na sequência certa, com um comando. Assim a recuperação não depende de quem está de plantão às 3h da manhã lembrar de cada detalhe.
4. Failback: a operação volta para casa
Quando o ambiente original está limpo e pronto, o failback devolve a carga de trabalho para ele, com tudo o que foi feito enquanto a empresa rodava na nuvem. A réplica volta a ficar em espera para a próxima vez.
5. Teste: o passo que quase ninguém faz
O failover de teste liga a réplica em uma rede isolada, separada da produção. Dá para verificar se o servidor sobe, se o sistema responde e quanto tempo tudo leva, sem que ninguém pare de trabalhar. É o teste que transforma o tempo de recuperação de uma estimativa em um número medido.
As duas metas que definem o seu plano
Antes de escolher ferramenta, a empresa precisa responder duas perguntas para cada sistema crítico:
- Quanto tempo esse sistema pode ficar parado? No mercado, essa meta se chama RTO (objetivo de tempo de recuperação).
- Quantos dados ele pode perder? É o RPO (objetivo de ponto de recuperação): a distância entre o último backup válido e o momento do desastre.
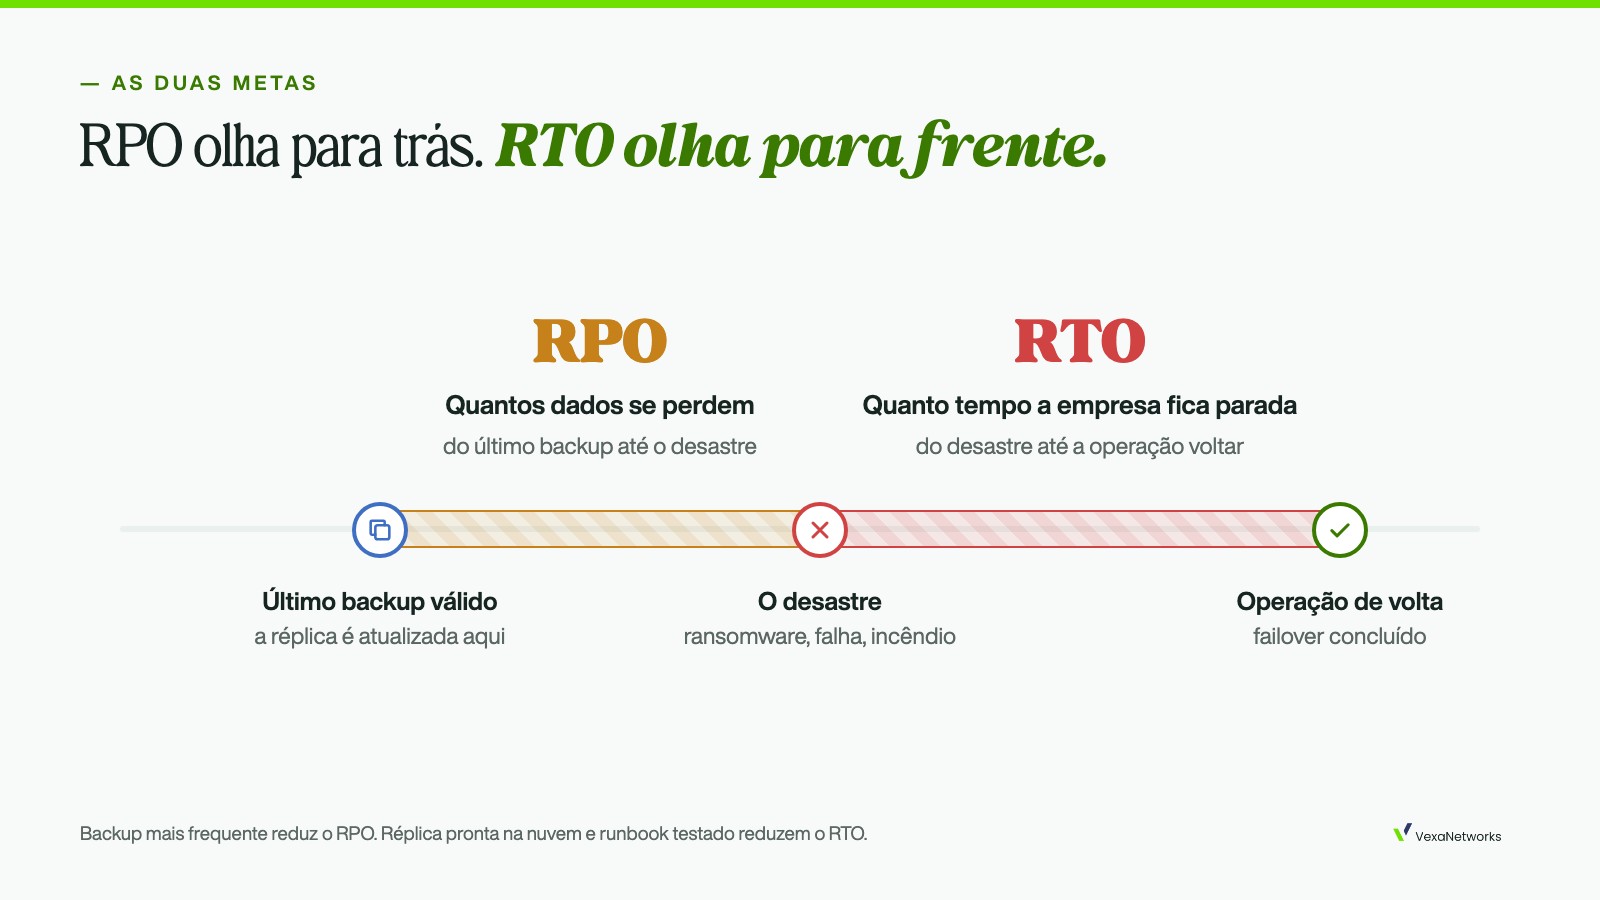
As metas mudam de sistema para sistema. O ERP que fatura pode exigir um RTO de minutos; o servidor de arquivos antigos talvez aguente um dia. É essa diferença que define o que vai para a recuperação em nuvem, com que frequência de backup e em que ordem.
O que avaliar antes de contratar
Nem toda solução chamada de “DR em nuvem” entrega a mesma coisa. Antes de contratar, confira:
- Backup protegido contra ataque. Se o ransomware consegue apagar ou criptografar as cópias, a réplica nasce comprometida. Procure backup imutável e credenciais separadas.
- Failover de teste sem parar a produção. Se testar exige desligar algo, o teste não vai acontecer.
- Runbooks para mais de um servidor. Sistemas de negócio quase sempre dependem de vários servidores ligados na ordem certa.
- Conectividade pronta. A VPN entre a empresa e a nuvem precisa estar configurada antes do desastre, não durante.
- Failback documentado. Voltar para casa também precisa ser simples, ou a empresa fica presa na nuvem.
- Quem opera no dia do desastre. Uma solução bem configurada e sem ninguém para acionar às 3h da manhã não resolve. Serviço gerenciado faz diferença.
Como a VexaNetworks entrega recuperação de desastres em nuvem
A VexaNetworks implanta e opera o Acronis Disaster Recovery sobre o backup Acronis que protege seus servidores. Na prática, o trabalho segue quatro etapas:
- Diagnóstico: mapeamos os servidores críticos, as dependências entre eles e as metas de tempo e de perda de dados de cada um.
- Implantação: configuramos a réplica na nuvem, a VPN e os runbooks com a ordem de recuperação.
- Teste: executamos o failover de teste em rede isolada e medimos o tempo real de volta.
- Operação: acompanhamos os backups, repetimos os testes periodicamente e conduzimos o failover e o failback quando for preciso.
Quanto tempo a sua empresa levaria para voltar hoje?
Em um diagnóstico de 30 minutos, online e sem compromisso, mapeamos seus servidores críticos e mostramos quanto tempo a volta levaria hoje e com a recuperação de desastres em nuvem.
Perguntas frequentes
Recuperação de desastres em nuvem substitui o backup?
Não. Ela funciona sobre o backup: a réplica na nuvem é criada a partir das cópias. Sem um backup confiável e protegido, não existe recuperação de desastres.
Quanto tempo leva o failover?
Depende do tamanho dos servidores e de quantos precisam subir juntos, mas costuma ser questão de minutos, e não de dias como na reconstrução a partir do backup. O failover de teste mostra o tempo real do seu ambiente.
Os usuários precisam mudar alguma coisa durante o failover?
Em geral, não. A rede da empresa é estendida para a nuvem por VPN e os servidores mantêm os mesmos endereços, então sistemas e usuários continuam encontrando o que precisam.
Funciona para servidores físicos e virtuais?
Sim. A réplica na nuvem é criada a partir do backup do servidor, seja ele físico ou virtual.
Com que frequência o plano deve ser testado?
Pelo menos a cada mudança relevante no ambiente e, como rotina, em intervalos regulares definidos com o time. Como o teste roda em rede isolada, ele não interrompe a produção.
Fontes: Uptime Institute, Annual Outage Analysis 2026; ITIC, Hourly Cost of Downtime Survey 2024; Sophos, State of Ransomware 2026 (EUA); Veeam, Ransomware Trends Report 2024; documentação do Acronis Cyber Disaster Recovery Cloud.